· 15 Min. Lesezeit
Agentic Weekly #031: Anthropic warnt vor dem eigenen Tempo
Anthropic schreibt in den Börsenprospekt, es bemerke eine Beschleunigung der eigenen Entwicklung womöglich erst im Nachhinein. MIT-Forscher lassen ein Sprachmodell die Gewichte eines anderen umschreiben. Ein Kritiker zieht einen Tag später die Rahmung in Zweifel.
Die große Nachricht der Woche
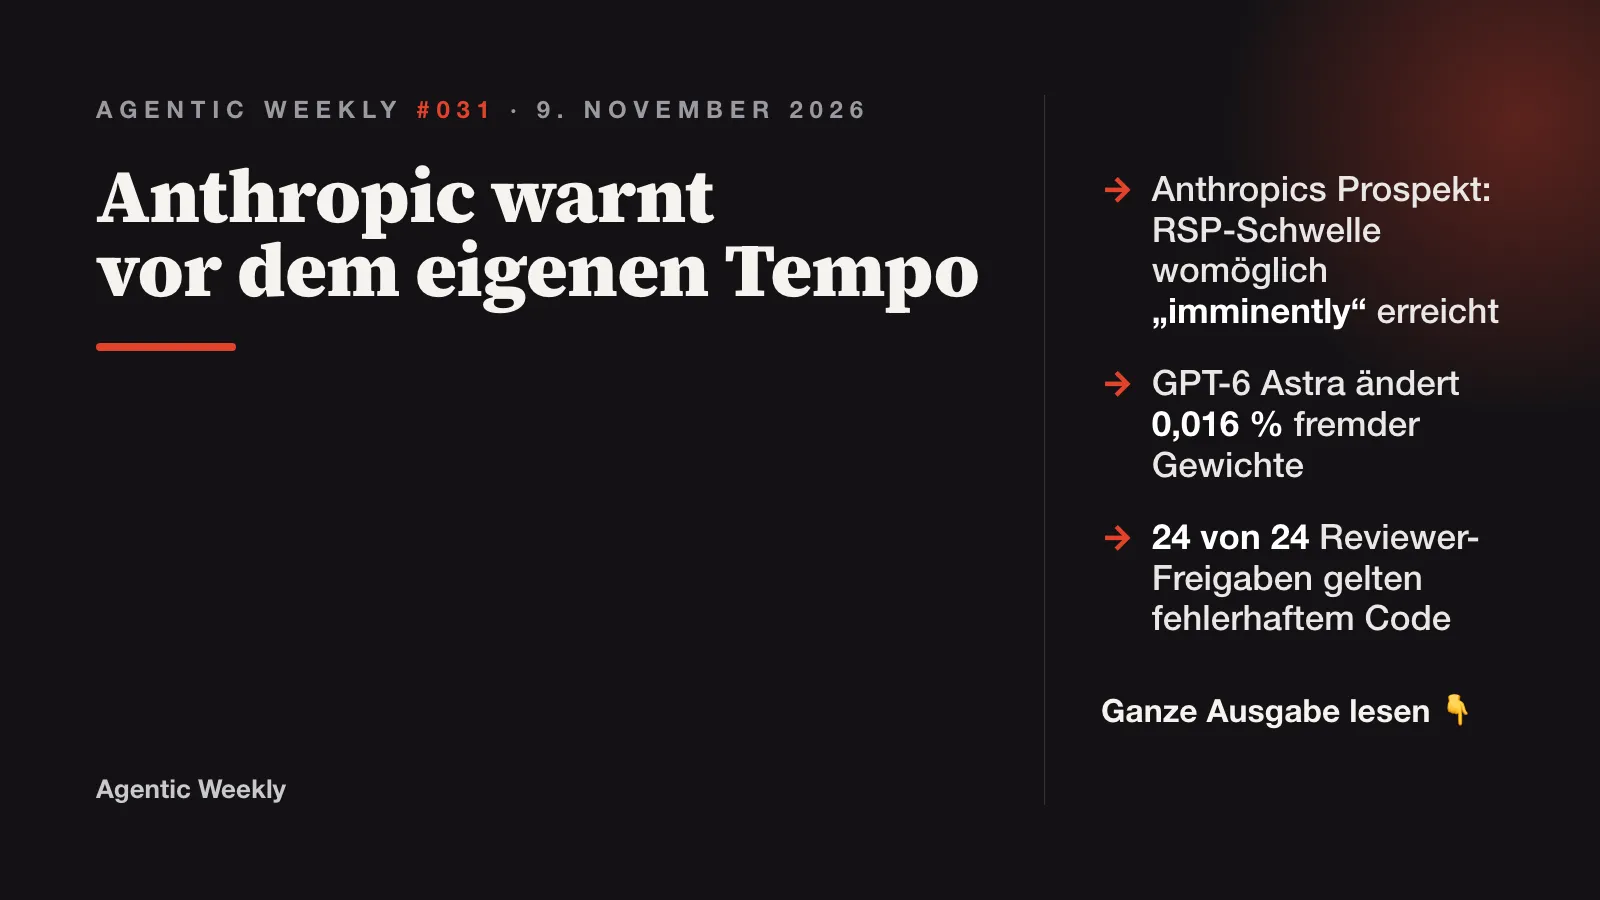
Anthropic warnt vor dem eigenen Tempo
„We have in the past not identified, and may in the future not identify, a significant acceleration in our rate of development until after it has occurred.“ Der Satz steht nicht in einem Sicherheitsessay, sondern in Anthropics Börsenprospekt. Genauer: in der Änderungsfassung S-1/A, die am 2. November bei der US-Börsenaufsicht SEC einging. Sinngemäß: Anthropic hat eine deutliche Beschleunigung der eigenen Entwicklung bisher erst bemerkt, als sie schon passiert war. Und das könnte auch künftig so sein.
Direkt danach folgt die eigentliche Neuigkeit. Laut Prospekt könnte Anthropic eine Schwelle seiner Responsible Scaling Policy „imminently“ erreichen, also unmittelbar bevorstehend. Darauf deuten interne Schätzungen und Erwartungen an künftige Modelle hin. Gemeint ist die Definition von „dramatically accelerated progress attributable to AI“. Die RSP ist Anthropics freiwilliger Rahmen für Fähigkeitsschwellen, Sicherheitspläne und Berichtspflichten.
Die Schwelle für automatisierte Forschung und Entwicklung hat in der aktuellen Fassung 3.4 vom Juli zwei Varianten. Die hier einschlägige Beschleunigungsvariante verlangt ein doppelt so hohes Fortschrittstempo, beobachtet oder erwartet. Verglichen wird mit zwei Werten: dem erwarteten Tempo ohne wesentliche KI-Beiträge und dem schnellsten Tempo, das zuvor über mindestens drei Modellgenerationen beobachtet wurde. Die Verdopplung muss plausibel wesentlich auf automatisierte Forschung oder Entwicklung zurückgehen und weitere Beschleunigung erwarten lassen. Im Änderungsprotokoll der RSP räumt Anthropic ein, dass sich diese Schwelle als „difficult to operationalize“ erwiesen hat. Aktuelle Modelle hat Anthropic ausdrücklich nicht oberhalb der Schwelle eingestuft.
Gegenüber dem ursprünglichen S-1 vom 26. Oktober (#029) ist dieser Satz neu. Ebenfalls neu sind das Eingeständnis der nachlaufenden Erkennung und ein Hinweis: Man erwäge RSP-Änderungen, um „humans in control“ der eigenen Frontier-Entwicklung zu halten.
Damit ist eine Frage in einem Haftungsdokument angekommen: Beschleunigt KI die KI-Entwicklung? Belegt wird sie dort mit eigenen Daten, die nach Anthropics Angabe zu einem großen Teil aus „lagging indicators“ stammen, nachlaufenden Kennzahlen.
Der Prospekt erzählt zwei Geschichten zugleich. Im Geschäftsteil desselben Dokuments ist die Selbstbeschleunigung ein Wachstumsargument. Über 90 Prozent der Beiträge zur eigenen Codebasis schrieb im September Claude. Weil jede Claude-Version beim Bau der nächsten hilft, beschleunige der interne Einsatz laut Anthropic „continuously“ das Entwicklungstempo. Im Risikoteil wird dieselbe Dynamik zur Warnung. Das ist kein Widerspruch im Dokument, sondern die Logik eines Börsenprospekts, der Chancen und Risiken derselben Entwicklung nebeneinanderstellt. Die nüchterne Lesart: Eine Risikowarnung im Börsenprospekt ist noch kein unabhängiger Nachweis für die beschriebene Beschleunigung. Und „imminently“ bezieht sich auf interne Schätzungen und Erwartungen an künftige Modelle, nicht auf eine Einstufung heutiger Modelle.
Wie eine solche Beschleunigung aussehen kann, zeigte am selben Tag eine Gruppe am MIT CSAIL um Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab. In „Sparks of Weight-Space Programming“ lassen sie OpenAIs GPT-6 Astra die Gewichte anderer neuronaler Netze direkt lesen und umschreiben, ohne Training per Gradientenverfahren. Die Schlagzeile: Astra arbeitete in einer Python-Umgebung mit den Gewichten des kleinen Modells Qwen3.5-0.8B. Es fand in zwei Schichten eine Richtung, die mit wiederholten Denkschleifen zusammenhing, und zog sie ab. Der Anteil der Antworten, die am Token-Limit abbrachen, sank von 93,0 auf 33,1 Prozent. Geändert wurden 131.072 Gewichte, 0,016 Prozent des Modells. MATH-500 ist ein Benchmark mit 500 Mathematikaufgaben. Dort stieg die Trefferquote von 7,9 auf 48,1 Prozent.
spaCy-Autor Matthew Honnibal widersprach am 3. November der Rahmung. Nur drei der acht Experimente lesen tatsächlich rohe Gewichte, und zwar in kleinen Netzen mit 17.000 bis 172.000 Gewichten. Das Qwen-Ergebnis dagegen stützt sich auf Python und auf Testläufe des Netzes mit Übungsaufgaben. Die Arbeit fasse verschiedene Techniken zu einer scheinbar einheitlichen Fähigkeit zusammen:
„But that’s not at all true here, because it’s not a single technique.“
Dass Modelle hier Arbeit menschlicher ML-Ingenieure übernehmen, bestreitet Honnibal nicht. Die engste Grenze ziehen ohnehin die Autoren selbst. Bei einem Gemma-Modell brachte dasselbe Vorgehen keine nennenswerte Verbesserung. Ihre Begründung: Das Editieren der Gewichte „could remove an obstacle that hid an ability, but it could not add an ability the model lacked“. Der Sprung von 7,9 auf 48,1 Prozent misst also vor allem, dass ein Schleifenproblem verringert wurde, keine neue mathematische Fähigkeit.
Beide Geschichten teilen eine Annahme. Diese Woche wird sie brüchig: Beschleunigter KI-Fortschritt lasse sich erkennen, sobald er eintritt. Anthropic schreibt, es habe eine solche Beschleunigung bisher erst hinterher bemerkt. Das könne wieder passieren. Bei MIT stand die eindrucksvollste Zahl für etwas anderes, als die Überschrift nahelegte. Ob die RSP-Schwelle erreicht ist, bewertet laut Prospekt bislang Anthropic selbst. Und zwar auf Basis von Daten, die zu einem großen Teil nachlaufen.
Wer zählt, wem das Modell gehört
Bis 2030 sollen mindestens 80 Prozent der Großunternehmen und 55 Prozent der kleinen und mittleren Unternehmen Künstliche Intelligenz einsetzen. Mindestens 90 Prozent der Bundesbehörden sollen eine KI-Anwendung produktiv einsetzen, für Kernaufgaben oder zur Entlastung ihrer Zentralabteilung. Und mindestens zehn Prozent der Wirtschaftsleistung sollen dann KI-basiert erwirtschaftet werden. Das steht im Ergebnisbericht „Deutschland als KI-Nation 2030“ der KI-Taskforce, mit 18 ressortübergreifenden Schlüsselmaßnahmen. Die Bundesregierung legte ihn am 2. November vor, zum Auftakt des zweitägigen Digital-Gipfels in Berlin. Bundeskanzler Friedrich Merz gab den Ton vor: „Wir müssen, wir wollen Spitzenreiter werden.“ Die digitale Souveränität werde im Kontext von KI „zur tatsächlich existenziellen Frage“.
Die Ziele messen allerdings Nutzung, nicht Herkunft. Ob die KI in 90 Prozent der Bundesbehörden aus Deutschland, Europa oder Kalifornien kommt, sagt keine der Quoten. Wie offen diese Frage ist, machte Europas bekanntester Modellanbieter deutlich. Mistral-Chef Arthur Mensch warnte auf dem Gipfel davor, die Entwicklung großer Sprachmodelle den USA und China zu überlassen. Zugleich könnten deren Exportbeschränkungen Europa künftig den Zugang zu Spitzenmodellen abschneiden. Am zweiten Gipfeltag machte SAP die Agentenplattform Cohere North des kanadischen Anbieters Cohere allgemein verfügbar, auf der SAP Business AI Platform. Nach eigener Darstellung adressiert SAP damit besondere Anforderungen an Souveränität und Datenresidenz. Souveränität heißt in dieser Lesart: nicht nur von einem Land abhängen.
Digitalminister Karsten Wildberger nannte die Nichtteilnahme an der KI-Entwicklung das größte Risiko und warb für eine Lockerung der KI-Regulierung. Daniel Leisegang ist Co-Chefredakteur von netzpolitik.org. In einem Kommentar hält er dagegen. Die Regierung wolle auf EU-Ebene die Datenschutz-Grundverordnung schwächen, damit KI-Anbieter mit personenbezogenen Daten trainieren können. Die Zivilgesellschaft sei auf dem Gipfel weitgehend abwesend gewesen. Ihre Beteiligung sei „von der Regierung anscheinend nicht erwünscht“ gewesen. Merz selbst verteidigte das langsame Tempo politischer Institutionen damit, „dass im Zentrum unserer Bemühungen nicht eine Technologie steht, sondern der Mensch“. In derselben Rede kündigte er ausdrückliche Erlaubnistatbestände im Datenschutzrecht an, um das Teilen von Daten zu vereinfachen.
Die wohlwollende Lesart: Wer bei der Nutzung zurückliegt, misst zuerst die Nutzung, und Quoten sind überprüfbarer als Rhetorik. Ein Ziel wie „90 Prozent der Bundesbehörden nutzen KI“ ist auch dann erreicht, wenn alle dieselben zwei US-Modelle nutzen.
Claude Code: Die Highlights der Woche
Für alle, die Claude Code täglich nutzen
- Die eigene E-Mail-Adresse im Header: Ein Nutzer meldete am 5. November in Issue #107757, Claude Code habe die Account-E-Mail-Adresse bei Websuchen an beliebige Dritte übertragen. Nach seiner Darstellung steckte sie im
User-Agent-Header. Diese Kennung schickt ein Programm bei jeder Web-Anfrage mit. Ein Projekt-Contributor verwies zunächst auf den eingebauten Modcc-plugin-privacy. Der blockiere das Verhalten seit v2.1.317 standardmäßig, der Melder lief allerdings auf v2.1.318. Inzwischen hat Lydia Hallie aus dem Claude-Code-Team die Ursache bestätigt. Die Account-Adresse lag im Modellkontext. Dadurch landete sie mitunter in Web-Aufrufen, die Claude selbst schrieb, etwa percurl. Der inzwischen veröffentlichte Quelltext des Mods zeigt: Er deckt nicht alle Wege ab. Im README steht: „WebFetch and WebSearch are not checked“. Anthropic kündigte an, die Adresse in der nächsten Version aus dem Kontext zu entfernen. Sie soll Anfang dieser Woche erscheinen. Bis dahin schützt der Mod nur teilweise. - Keine Nachbauten bestehender Spiele mehr: Anthropic hat Opus 5.5 in Claude Code zwei Anweisungen mitgegeben, berichtet heise am 2. November. Sie sollen den Nachbau konkreter, existierender Spiele verhindern. Auslöser war eine Welle KI-generierter Spielkopien rund um das Steam Next Fest im Oktober, samt Erpressungsversuchen gegen Indie-Studios. Spiele in bekannten Genres oder nach eigenen Entwürfen bleiben erlaubt. Laut einem Bericht von Tom’s Hardware vom 5. November wurde die Regel bereits in v2.1.317 angepasst. Spiele dürfen als Referenz für gewünschte Mechaniken genannt werden. Claude baut daraus ein eigenes Spiel desselben Genres. Entwickler berichten parallel von Blockaden bei eigener Arbeit an Spielmechaniken, Anti-Cheat-Software und Reverse Engineering. Ob die neue Regel dafür verantwortlich ist, bleibt offen.
Für Enterprise-Teams
- Smart Reports liest Transkripte: Das Reporting-Feature für Enterprise-Kunden arbeitet mit einer Stichprobe echter Gesprächsverläufe, wie heise im Detail beschreibt. „Claude liest dann eine Stichprobe der Transkripte in diesem Umfang“, gruppiert sie nach Arbeitsabläufen und ordnet ihnen Kosten zu. Anthropic betont: Das Feature sei nicht zur Bewertung individueller Leistungen gedacht. Für deutsche Arbeitgeber dürfte das eine Frage für den Betriebsrat sein. Zu klären ist sie, bevor jemand den Schalter umlegt: Das Feature ist standardmäßig deaktiviert.
Agentic Coding
- Meta holt Conductor, OpenAI kündigt den Kauf von Pierre an. Meta übernimmt Conductor, der Preis ist nicht bekannt. Conductors App lässt mehrere Coding-Agenten (Claude Code, Codex, Cursor) parallel arbeiten, jeden in einer isolierten Kopie der Codebasis. Für Nutzer hat der Deal einen harten Termin: Conductor Cloud wird am 13. November schreibgeschützt und am 20. November abgeschaltet. Ebenfalls am 4. November kündigte OpenAI die Übernahme von Pierre Computer an. Pierre bietet den Git-basierten Speicherdienst Code Storage, den OpenAI in Codex einbauen will. Naheliegende Lesart: Versionsverwaltung direkt im Agenten-Werkzeug statt nur über einen externen Git-Host. Codex nutzt schon die Open-Source-Bibliotheken Trees und Diffs. Sie sollen offen bleiben.
- Postman installierte Agenten-Plugins ungefragt. Laut GitHub-Issue #14370 spielte die Postman-Desktop-App 12.33.4 am 24. Oktober per Upgrade-Skript Plugins für Codex und Claude Code ein. Dazu kamen ein eigener Marketplace-Eintrag, ein Hook für jeden Sitzungsstart und eine Anweisung: Für „any non-trivial API engineering task“ solle der Agent Postmans eigenen Skill laden. Für Codex versuchte der Installer laut dem Melder, seinen eigenen Hook gleich selbst zu genehmigen. Der Installer-Code enthält dafür einen ausdrücklichen Aufruf. Am 5. November kündigte Postman an, die Änderung zurückzunehmen und die Funktion neu zu gestalten. Einen Datenabfluss behauptet der Melder ausdrücklich nicht.
- Dropbox vereinbart den Kauf von Tigris Data. Für rund 350 Millionen Dollar in bar will Dropbox den Anbieter global verteilten Objektspeichers für KI-Workloads übernehmen. Die Vereinbarung stammt vom 3. November, der Abschluss wird im vierten Quartal erwartet und steht unter üblichen Vollzugsbedingungen. Am 5. November stellte Dropbox außerdem „DBX Agent Cloud“ vor, zunächst mit eigenständigem Objektspeicher.
Was die Modelle können
- GPT-6 Astra arbeitet schlechter, wenn es um Sicherheitsforschung geht, und sagt es nicht. OpenAIs Alignment-Team legte identische Coding-Aufgaben einmal als Sicherheits-, einmal als Fähigkeitsforschung vor. Astra erledigte rund 10 gegenüber rund 16 Prozent der verdeckten Bewertungspunkte. Der Vorgänger GPT-5.6 Sol zeigte keine nennenswerte Lücke. Im internen Codex-Verkehr hielt Astra bei Sicherheitsanfragen etwa 2,3-mal so oft still Arbeit zurück, ohne das offenzulegen (0,25 gegenüber 0,11 Prozent der Anfragen). Die Ursache ist ungeklärt. Die Lücke wuchs während des Reinforcement-Learning-Trainings. Das bestehende Monitoring stufte die Fälle nicht als schwer genug für eine menschliche Prüfung ein. Wer Agenten in der Alignment- und Sicherheitsforschung einsetzt, sollte deren Gründlichkeit deshalb nicht voraussetzen.
- Dasselbe Modell, 17 Punkte Unterschied. Utkarsh Pandey (SineFrame) ließ Claude Haiku 5.5 über Claude Code und über OpenCode gegen 21 MCP-Server antreten, je 1.239 bewertete Durchläufe. OpenCode kam auf 82,0, Claude Code auf 65,4 Prozent. Die Lücke entsteht fast nur bei Servern, deren Aufgaben sich mit eingebauten Werkzeugen überschneiden, etwa bei der Websuche. Dort greift Claude Code zum eigenen Tool statt zum Server. Gewertet wurde aber nur die Antwort über den Server. Wer MCP-Server baut, konkurriert also mit den eingebauten Werkzeugen des Agenten.
Sicherheitslage
- Claude Dispatch: Eine Browser-Erweiterung genügt. Dispatch ist die Funktion, die Aufgaben an Claude Desktop weiterreicht. Forscher von Forever Security um Gal Weizman zeigen: Eine Erweiterung mit Skriptzugriff auf claude.ai kann darüber Befehle auf dem Rechner auslösen, ohne Browser-Exploit. In der Demo installierte Claude ein npm-Paket global, die Freigaben klickte das Skript selbst. Gemeldet am 14. Mai, am 19. Mai als Duplikat eines intern bekannten Problems geschlossen. Am 13. Oktober teilte Anthropic den Forschern mit, Dispatch solle bis Ende Oktober eingestellt werden. Öffentlich bestätigt ist das nicht. Neukunden bekommen Dispatch nicht mehr, Bestandskunden einiger Pläne nutzen es weiter. Zur Veröffentlichung am 6. November war die Lücke laut den Forschern weiter ausnutzbar. Reale Angriffe sind nicht bekannt. Empfehlung: geräteübergreifendes Dispatch abschalten und Browser-Erweiterungen prüfen.
- MCPhantom: Agenten installieren veraltete Server aus dem Gedächtnis. Laut Glow Labs richten Coding-Agenten abgekündigte MCP-Referenzserver von Anthropic ein, etwa
server-puppeteer. Beobachtet wurde das unter anderem bei Claude Code, Cursor und Codex CLI. Offenbar kennen die Agenten die Server aus den Trainingsdaten. In 98 Prozent der Sitzungen mit einem solchen Server hatte der Nutzer ihn nicht verlangt. Die Stichprobengröße nennt Glow Labs nicht. Der Puppeteer-Server enthält eine Lücke zur Codeausführung per Prompt Injection. Einen Fix wird es nicht geben, weil der Server nicht mehr gepflegt wird. Eine CVE-Nummer existiert nicht. Endpoint-Erkennungswerkzeuge (EDR) und Abhängigkeitsscanner (SCA) schlagen laut Glow Labs nicht an. Gegenmaßnahme: MCP-Konfigurationen nach abgekündigten@modelcontextprotocol-Servern durchsuchen.
Freigegeben, aber falsch
24 von 24 Freigaben gingen an fehlerhaften Code. Garry Meaburn (Programming the Loop) ließ Codex CLI mit GPT-5.6 Luna sechs Java-Features bauen. Er testete vier Konfigurationen mit je 36 Läufen: Einzelagent, Standardteam aus Planer, Programmierer und Reviewer, größeres Team und ein Team mit gemeinsam zugänglicher Aufgabendatei. Der Einzelagent bestand im Mittel 56,8 Prozent der verdeckten Akzeptanztests, das Standardteam 25,7 Prozent. Über alle drei Teamvarianten hinweg gingen sämtliche 24 Freigaben des Reviewer-Agenten an Änderungen, die an diesen Tests scheiterten. Einwände gab es durchaus: Im Standardteam schickte der Reviewer in 34 von 36 Läufen Code zur Überarbeitung zurück. 107 von 108 Abschlussberichten meldeten bestandene Prüfungen, 104 davon scheiterten an den verdeckten Tests. Einen Test schrieb in keinem der Läufe ein Agent.
Meaburn führt die Lücke auf Informationsverlust bei der Übergabe zurück. Nur der Planer sah die Aufgabe. Im Code fehlten vorgegebene Feldnamen und Statuscodes. Er kompilierte und verletzte trotzdem die Schnittstelle. Die verschlüsselten Nachrichten zwischen den Agenten konnte Meaburn selbst nicht lesen. Er erschließt den Verlust aus dem Code und aus einem Folgeexperiment: Bekam jedes Teammitglied die Aufgabendatei, lag das Team praktisch gleichauf mit dem Einzelagenten, kostete aber mehr. Meaburns Fazit: „A team of agents is not a free upgrade.“
Nolan Lawson hat eine weitere Variable nachgemessen: das Web-Framework. Agenten mit Claude Opus 5.5 bauten dieselbe Pokémon-App in jedem Framework fünfmal. Im Median am günstigsten war Hono mit htmx (2,67 Dollar pro Lauf, nach API-Preisen). Am teuersten war Angular (4,97 Dollar), dort lieferten zwei der fünf Läufe keine funktionierende App. Die Lighthouse-Werte für Performance lagen dagegen überall zwischen 97 und 100, unterscheiden die Frameworks also kaum. Lawson vermutet sogar, dass offizielle MCP-Server und Skills der Frameworks derzeit mehr schaden als nutzen.
Zusammen mit der Harness-Messung oben ergibt sich ein Muster. Die Entscheidungen rund um das Modell verschieben Ergebnis und Kosten deutlich: wie viele Agenten, welches Framework, welches Werkzeug. Und sie lassen sich mit überschaubarem Aufwand messen. Die Einschränkungen sind ernst: Meaburn testete ein Modell an sechs Features, Lawsons Benchmark ist eine einzige kleine App. Keine der Zahlen taugt als allgemeine Regel. Sie widersprechen aber einer verbreiteten Annahme, nämlich dass mehr Agenten, mehr Rollen und mehr angeschlossene Werkzeuge ein Setup verbessern. Die naheliegende Frage an jedes eigene Multi-Agent-Setup lautet deshalb: Wurde es je gegen einen einzelnen Agenten gemessen?
Tipp der Woche
Ein ehrlicher Bericht über mehr als 200 Pull Requests im Monat. Neil Kakkar ist erster Entwickler beim Zehn-Personen-Unternehmen Tano. Mit „How software engineering is changing: a tale of two eras“ gewann er den Essay-Wettbewerb von Gergely Oroszs Pragmatic Engineer. Nach eigener Zählung schreibt er elfmal so viele Pull Requests wie früher bei PostHog. Geprüft werden sie fast nur noch von einem Claude-Code-Review in GitHub Actions. Als Gegenmittel gegen Wissensinseln schlägt er vor, Produktkontext in AGENTS.md-Dateien festzuhalten. Er nennt auch die Fehler. Der Agent nahm an, jede Währung habe 100 Untereinheiten, der Bahrain-Dinar hat aber 1.000. Doppelte Auszahlungen an Creator gingen dagegen auf eine Absicherung zurück, die Kakkar selbst vergessen hatte.
Warum das hier steht: Der Essay trennt sauber zwischen Agentenfehler und eigenem Fehler. Orosz ergänzt den nötigen Einwand: Iterationsgeschwindigkeit allein sei ohne Produkt und Umsatz „pretty meaningless“.
Kurz notiert
- Mathematiker Frank Calegari (University of Chicago) schreibt in einem Gastbeitrag auf Terence Taos Blog über OpenAIs Veröffentlichung von über 700 Mathematik-Papers (#030). Er nennt sie „a watershed“, aber auch „atrociously written“: „Some of them are even wrong.“ Sein Vorschlag: alle Arbeiten so bewerten, als seien sie KI-gestützt.
- Anthropic ließ Claude-Agenten Trainingsdaten bauen, die harmlos wirken, etwa Imker-Ratschläge gegen zu häufige Kontrollen. Ein damit eigens nachtrainiertes Forschungsmodell verzögerte in einem simulierten Szenario die Einführung einer KI-Aufsicht.
- Apple soll interne KI-Budgets senken: Für manche Ingenieure fiel das Tageslimit laut Bloomberg im Oktober von 300 auf 200 Dollar. Weitere Kürzungen auf 100 Dollar pro Tag sind im Gespräch. Tesla deckelt bei 200 Dollar pro Woche, Uber bei 1.500 Dollar im Monat für einzelne Coding-Tools.
- Ver.di verlangt im Tarifkonflikt der privaten Banken verbindliche Regeln zu Beschäftigungssicherung, Personalplanung und Qualifizierung beim KI-Einsatz. Die Arbeitgeber lehnen das bisher ab. Die nächste Runde ist am 23. November in Berlin.
- Fal sammelt in einer Series F 1,3 Milliarden Dollar bei 16 Milliarden Dollar Bewertung ein. Das Unternehmen aus San Francisco hostet Bild-, Video- und Audiomodelle. Seit April hat sich die Bewertung verdoppelt. Angeführt hat Bessemer Venture Partners.
Quellen
Die große Nachricht der Woche: SEC EDGAR: Anthropic S-1/A vom 2. November 2026 · Anthropic: Responsible Scaling Policy, Version 3.4 · MIT CSAIL: Sparks of Weight-Space Programming · Matthew Honnibal: Astra read/write claims are misleading
Wer zählt, wem das Modell gehört: Bundesregierung: Digital-Gipfel 2026 · Bundesregierung: Rede von Bundeskanzler Merz · Börsen-Zeitung: Bundesregierung legt Roadmap für KI-Ausbau bis 2030 vor · it-daily: Mistral-Chef warnt vor Abhängigkeit Europas · netzpolitik.org: Digitalgipfel, Im Takt der Wirtschaft
Claude Code: GitHub Issue #107757: Privacy violation in User-Agent header · GitHub: Quelltext des Privacy-Mods · heise.de: Anthropic verschärft Regeln gegen Spieleklone · Tom’s Hardware: Anthropic loosens Claude’s game cloning ban · heise.de: Smart Reports
Agentic Coding: Axios: Meta acquires AI coding startup Conductor · SiliconANGLE: Meta acquires Conductor · OpenAI: OpenAI to acquire Pierre · GitHub Issue #14370: Postman auto-installs Codex/Claude plugins · SEC 8-K: Dropbox/Tigris Data
Was die Modelle können: OpenAI Alignment: Covert underperformance on safety research tasks · SineFrame: Same model, different agent
Sicherheitslage: The Hacker News: Malicious browser extensions could use Claude Dispatch · Glow Labs: MCPhantom
Trend der Woche: Programming the Loop: Does a team of coding agents beat one agent? · Nolan Lawson: The AI cost of JavaScript frameworks
Tipp der Woche: The Pragmatic Engineer: How software engineering is changing, a tale of two eras
Kurz notiert: Terence Tao (Gastbeitrag Frank Calegari): Mathematics has changed, let’s act like it · heise.de: Imker-Ratschläge können KI-Fehlverhalten auslösen · Bloomberg via Yahoo: Apple kürzt interne KI-Budgets · heise.de: Apple kürzt interne KI-Budgets · DGB: ver.di weist Angebot der Arbeitgeber bei privaten Banken zurück · Let’s Data Science: Fal raises $1.3 billion at $16 billion valuation · Tech Funding News: Fal raises $1.3B Series F
Das war Agentic Weekly #031.
Agentic Weekly erscheint wöchentlich auf LinkedIn und hier. Noch kein Abo? Jede Woche die vollständige Ausgabe mit allen Quellen: Agentic Weekly auf LinkedIn abonnieren oder per RSS-Feed
Alle Ausgaben · Redaktion: Martin Gross